Plan de hoy: tres bloques
| # | Bloque | Pregunta que responde |
|---|---|---|
| 1 | Localización de Markov | ¿Cómo combina el robot lo que hace con lo que ve, si no sabe dónde empezó? |
| 2 | Filtro de Kalman | ¿Cuánto le creo a la odometría y cuánto al marcador? |
| 3 | SLAM | ¿Y si nadie le dio el mapa al robot? |
Al final: los tres bloques funcionando en RHINO, en el simulador.
Localización de Markov
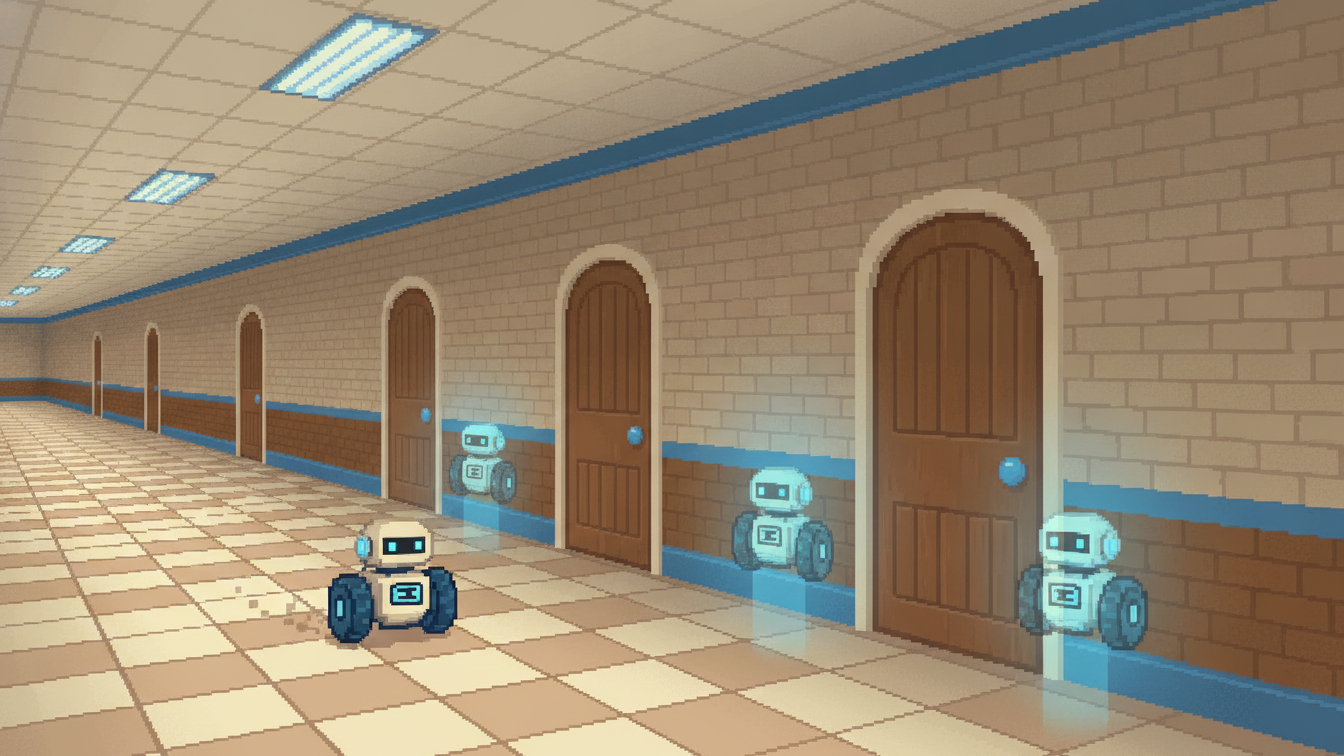
Localización de Markov
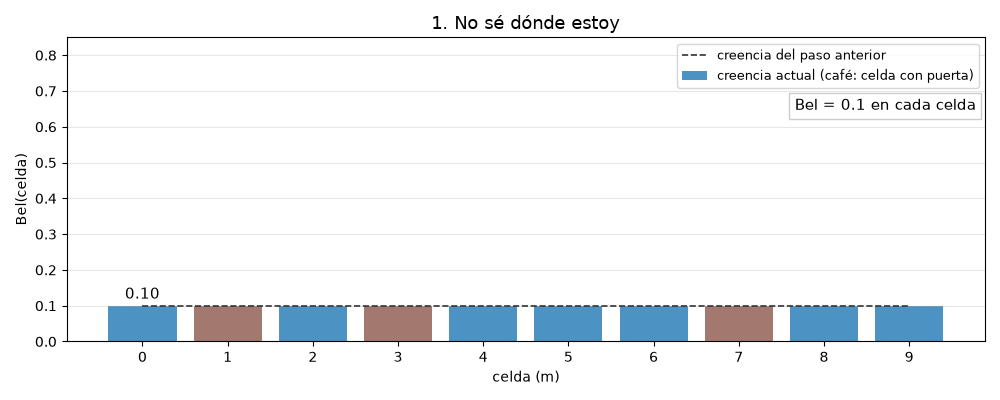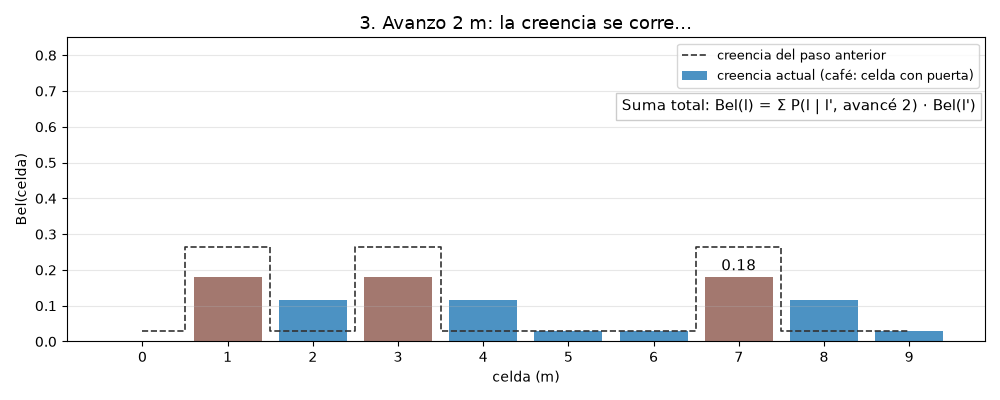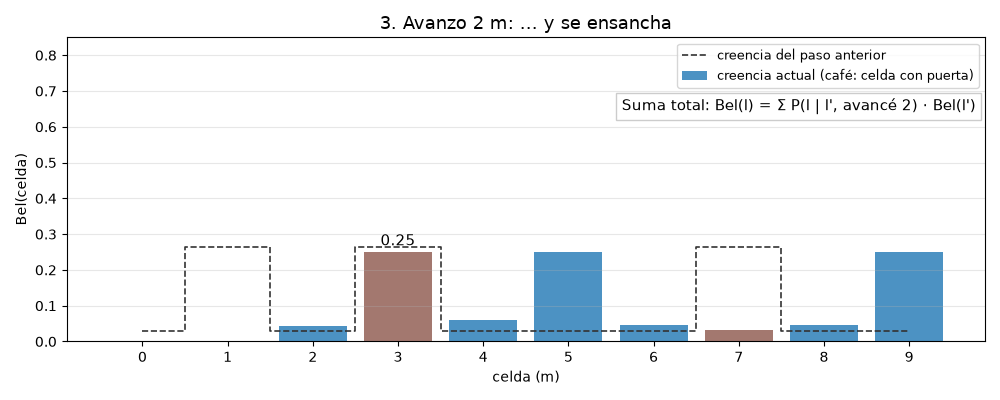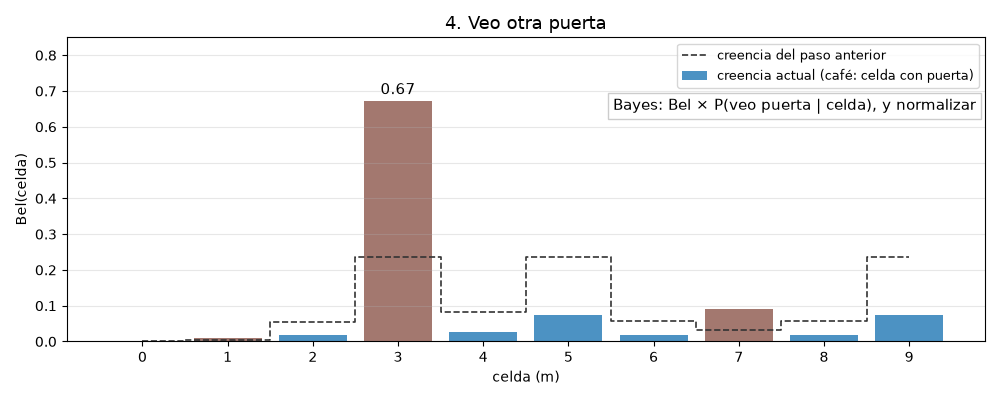
- La creencia $Bel(l)$ asigna una probabilidad a cada lugar $l$ del mapa, y suman 1
- Es el pasillo de la semana 13, ahora con 10 celdas de 1 m y números
Actualización de percepción: Bayes
$$P(l \mid i) = \frac{P(i \mid l)\, P(l)}{P(i)}$$
- $P(l)$: creencia antes de mirar
- $P(i \mid l)$: modelo del sensor: probabilidad de leer $i$ estando en $l$
- $P(i)$: suma de todos los productos: normaliza
- $P(l \mid i)$: creencia después de leer $i$
| Celdas | Antes | P(veo puerta) | Producto | Después |
|---|---|---|---|---|
| con puerta (3) | 0.1 | 0.9 | 0.09 | 0.09 / 0.34 = 0.26 |
| sin puerta (7) | 0.1 | 0.1 | 0.01 | 0.01 / 0.34 = 0.03 |
| suma | 1.0 | 0.34 | 1.0 |
Actualización de acción: suma total
$$P(l_t \mid o_t) = \sum_{l'} P(l_t \mid l', o_t)\; P(l')$$
- $l'$: celda donde estaba · $l_t$: celda donde estoy ahora · $o_t$: la odometría, lo que dicen los encoders
- $P(l')$: creencia anterior · $P(l_t \mid l', o_t)$: modelo de movimiento (la tabla)
| Orden: avanzar 2 celdas | Probabilidad |
|---|---|
| quedó en $l' + 1$ (patinó) | 0.1 |
| quedó en $l' + 2$ | 0.8 |
| quedó en $l' + 3$ (se pasó) | 0.1 |
Cada pico se corre y se ensancha: moverse siempre agrega incertidumbre
El ciclo de Markov
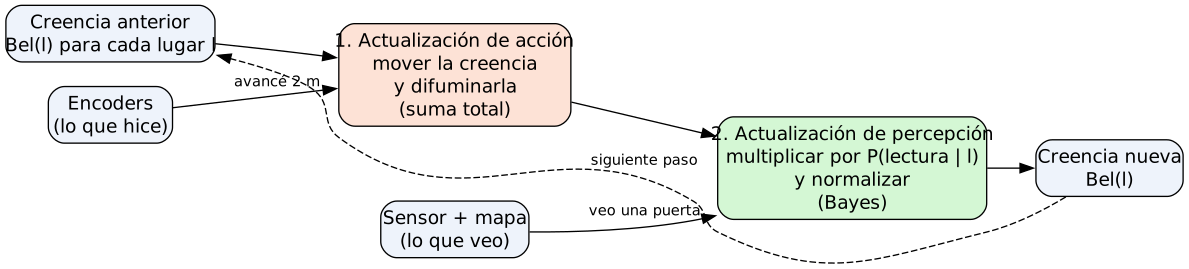
- La suposición de Markov: la creencia nueva solo depende de la anterior y de la última acción y lectura
En Python
puerta = np.array([0, 1, 0, 1, 0, 0, 0, 1, 0, 0])
bel = np.ones(10) / 10                        # no sé dónde estoy

def percibir(bel, veo_puerta):
    p = np.where(puerta == veo_puerta, 0.9, 0.1)   # P(lectura | celda)
    bel = p * bel                                  # Bayes
    return bel / bel.sum()                         # normalizar

def mover(bel, celdas):
    nueva = np.zeros_like(bel)
    for paso, q in [(celdas - 1, 0.1), (celdas, 0.8), (celdas + 1, 0.1)]:
        nueva[paso:] += q * bel[:len(bel) - paso]  # suma total
    return nueva / nueva.sum()

bel = percibir(bel, 1); bel = mover(bel, 2); bel = percibir(bel, 1)
¿Y en un piso de verdad?
| Grilla de 2 × 2 m | Celdas a actualizar en cada paso |
|---|---|
| 1 cm y 1° | 200 × 200 × 360 = 14.4 millones |
| 5 cm y 5° | 40 × 40 × 72 = 115 200 |
- La resolución de la creencia no puede ser mejor que la de la grilla
- Con celdas gruesas el cálculo es manejable, pero se pierde precisión
RHINO: guía de museo
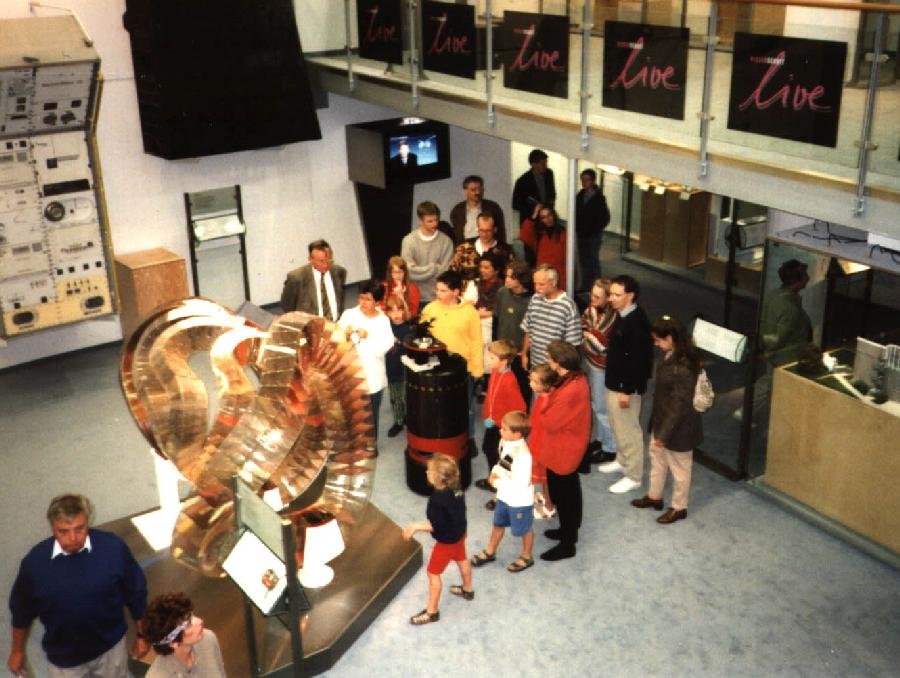
| Deutsches Museum Bonn, mayo de 1997 | |
|---|---|
| operación | 6 días · 47 horas |
| recorrido | 18.6 km · hasta 80 cm/s |
| visitantes | más de 2000 en el museo |
| tours pedidos | 2400 · 99.75 % cumplidos |
| sensores | láser, sonar, infrarrojo y táctil |
Fotos: proyecto RHINO, Universidad de Bonn · Datos: Burgard et al., The Interactive Museum Tour-Guide Robot, AAAI 1998
¿Cómo se localizaba RHINO?
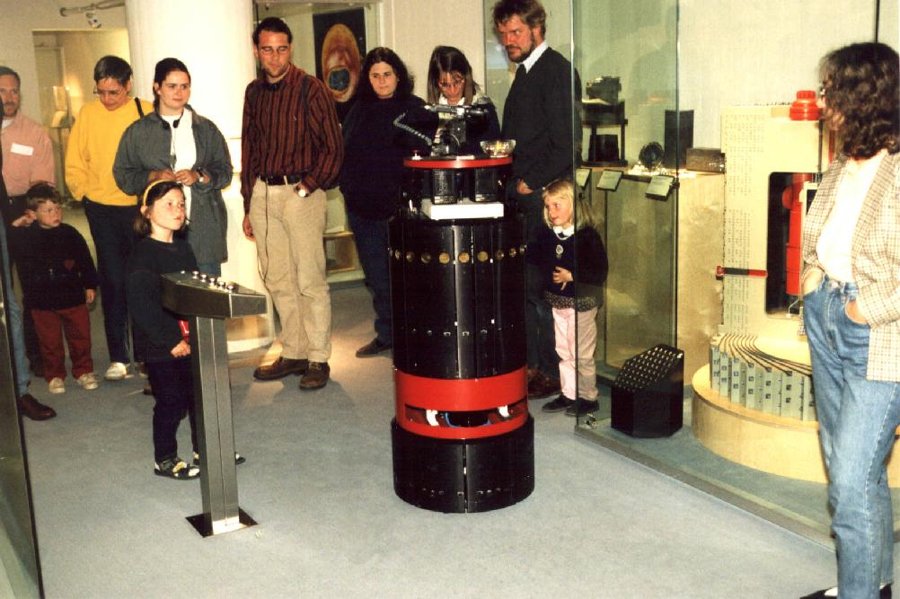
- Markov en una grilla de $(x, y, \theta)$ de 15 cm y 2°: Bayes al medir, suma total al moverse
- Arrancaba con creencia uniforme: localización global
- Filtro de entropía: descarta las lecturas tapadas por personas
- Obstáculos invisibles (vitrinas, barras, consolas): con la pose más probable y el mapa genera lecturas virtuales
- Error menor que 15 cm en 118 puntos de referencia
Fox, Burgard, Thrun y Cremers, Position Estimation for Mobile Robots in Dynamic Environments, AAAI 1998
RHINO en video
"Rhino the tour guide robot" · Wolfram Burgard
Filtro de partículas
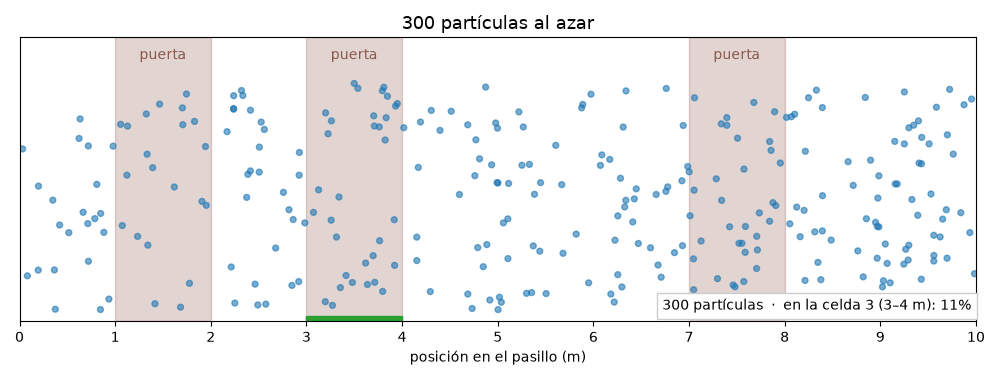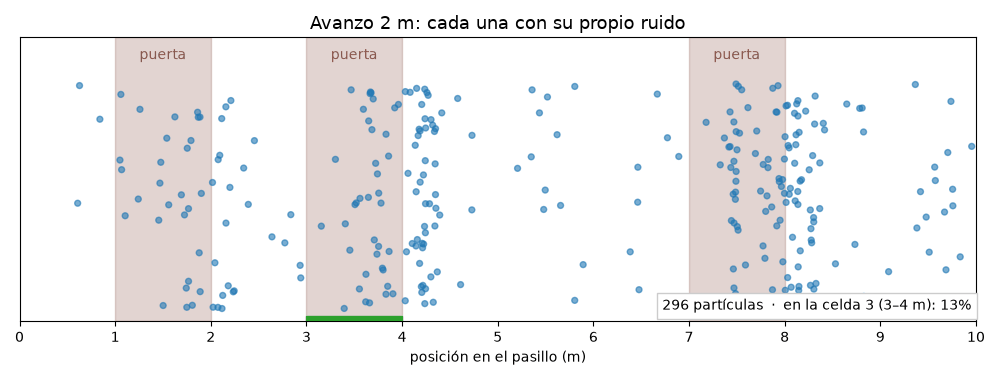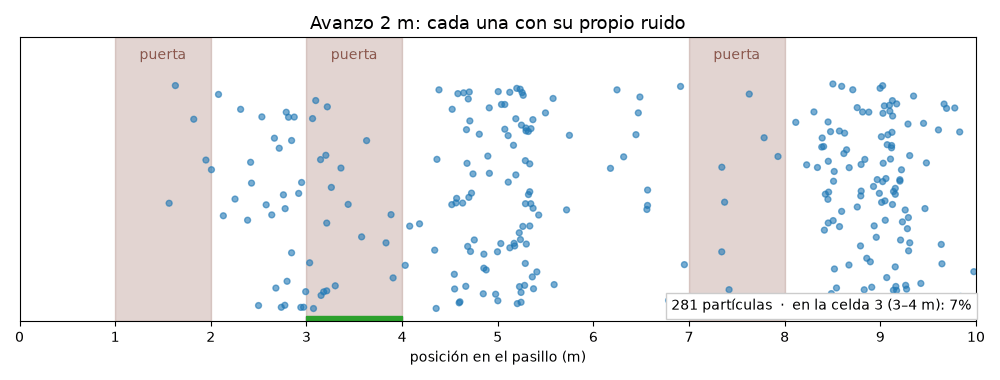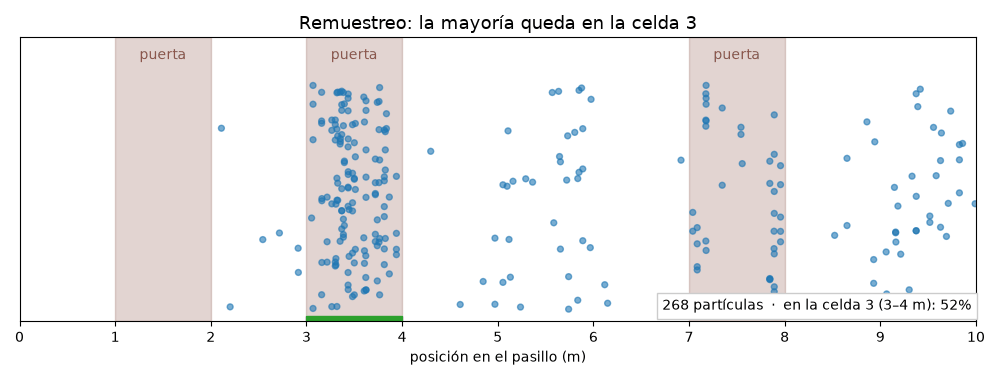
- En lugar de todas las celdas, unas cientos de hipótesis que se pesan y se remuestrean
Filtro de Kalman
Filtro de Kalman
| Si la creencia es una campana de Gauss | basta guardar |
|---|---|
| posición | la media $\hat{x}$ |
| incertidumbre | la varianza $P = \sigma^2$ (en 2D, la covarianza $\Sigma$) |
- Markov con muchas celdas → Kalman con dos números por variable
- Supone: modelos lineales, ruido gaussiano y de media cero, una sola hipótesis
Fusionar dos medidas
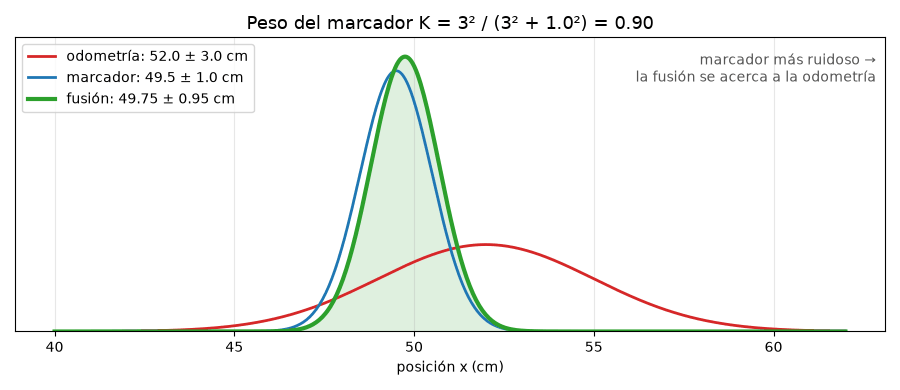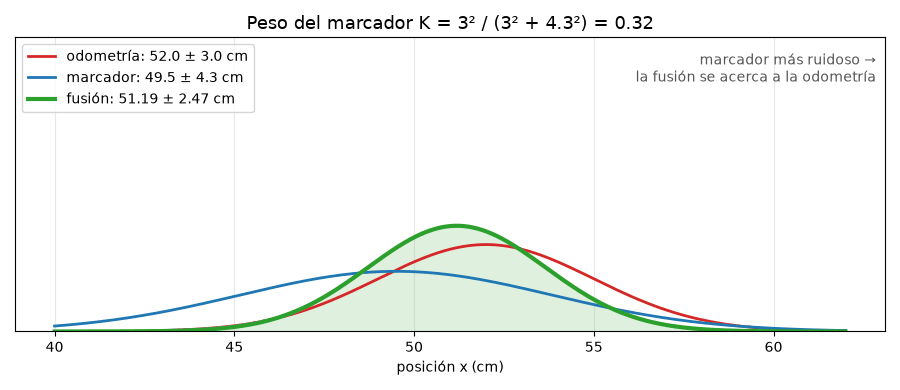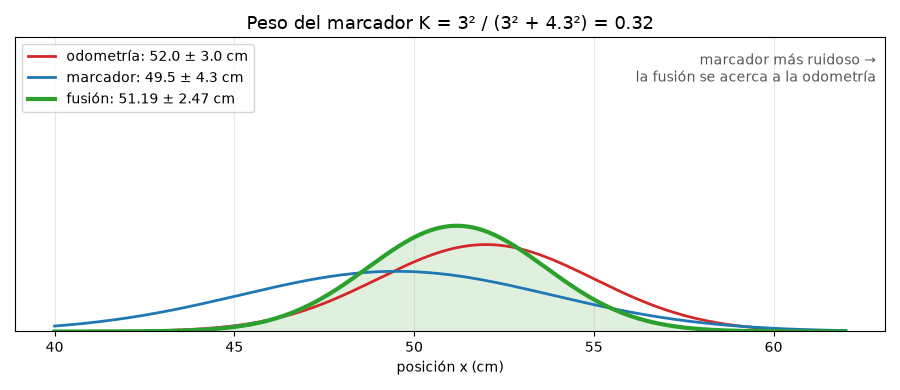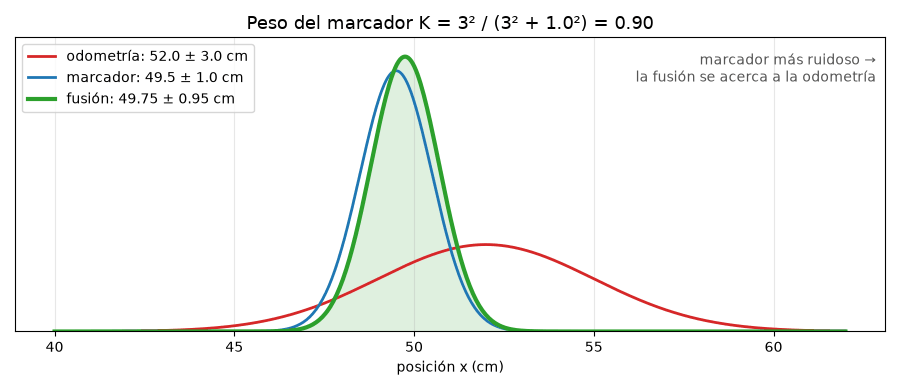
$$\hat{x} = \frac{\sigma_2^2\, x_1 + \sigma_1^2\, x_2}{\sigma_1^2 + \sigma_2^2} \qquad \sigma^2 = \frac{\sigma_1^2\, \sigma_2^2}{\sigma_1^2 + \sigma_2^2}$$
- $x_1,\ \sigma_1^2$: odometría y su varianza · $x_2,\ \sigma_2^2$: marcador y su varianza · $\hat{x},\ \sigma^2$: fusión y su varianza
La ganancia de Kalman
$$K = \frac{P^-}{P^- + R}$$
$$\hat{x} = \hat{x}^- + K\,(z - \hat{x}^-) \qquad P = (1 - K)\, P^-$$
- $\hat{x}^-,\ P^-$: predicción y su varianza
- $z,\ R$: medida del marcador y su varianza
- $z - \hat{x}^-$: innovación
- $K$: ganancia, entre 0 y 1
- $\hat{x},\ P$: estimación corregida y su varianza
| Ejemplo: P⁻ = 9 cm², R = 1 cm² | K = 9 / 10 = 0.9 |
|---|---|
| innovación | 49.5 − 52 = −2.5 cm |
| corrección: K × innovación | 0.9 × (−2.5) = −2.25 cm → 49.75 cm |
| K → 1 (marcador perfecto) | le creo al marcador: lo de la semana 13 |
| K → 0 (marcador malo) | lo ignoro: solo odometría |
Predecir y corregir
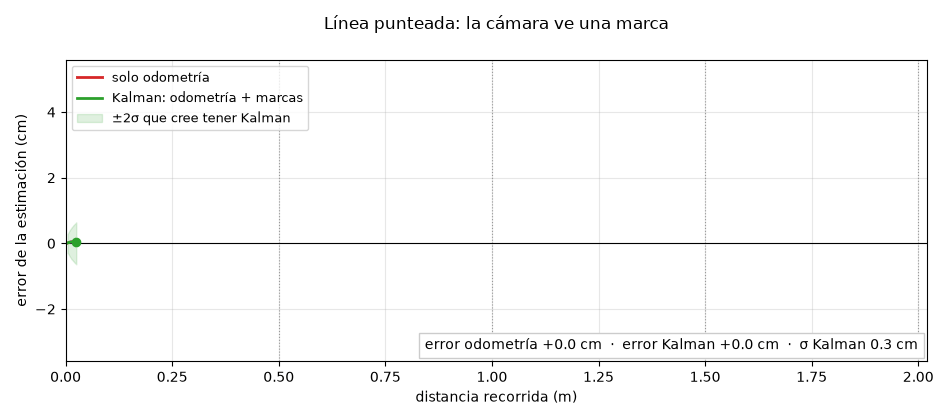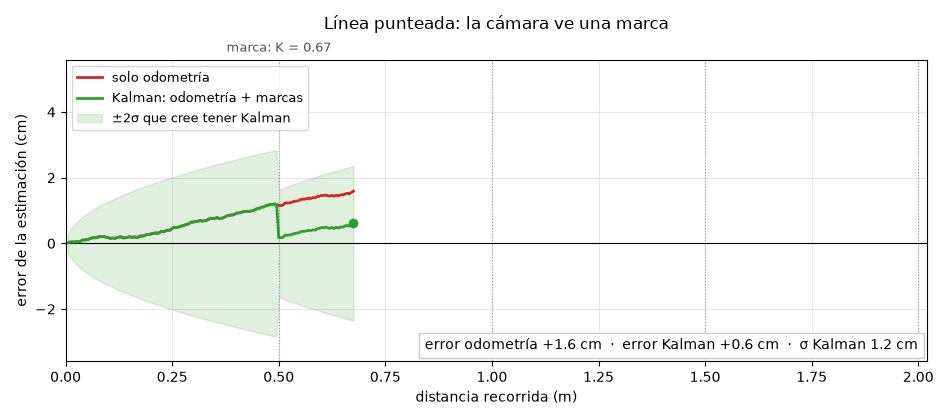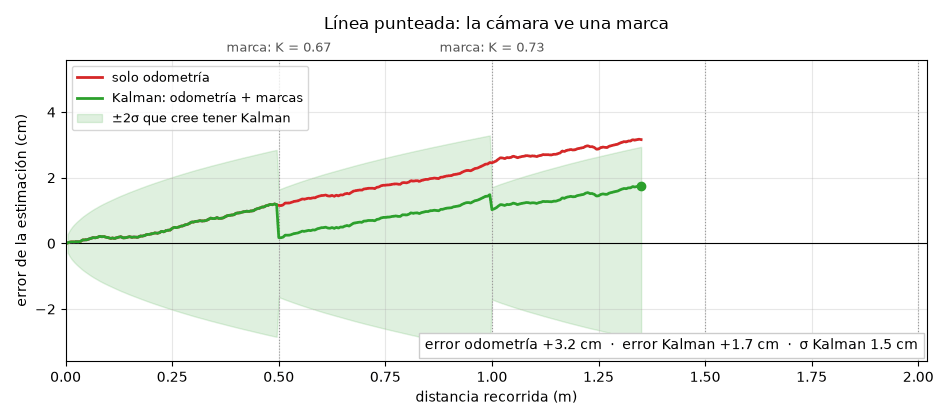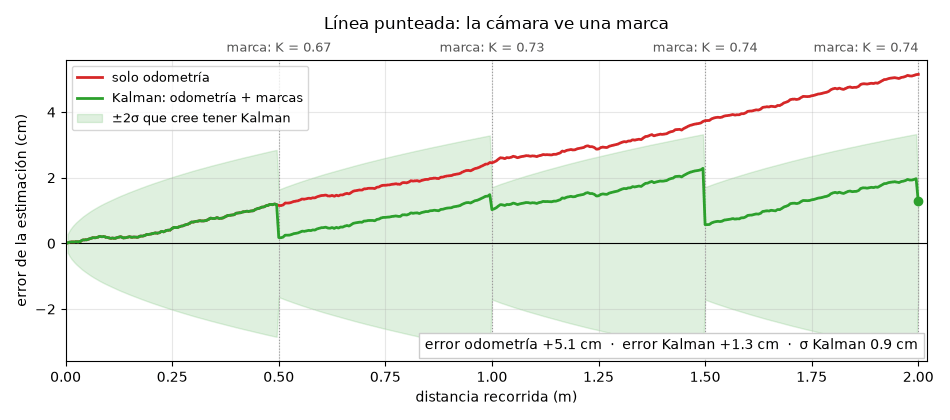
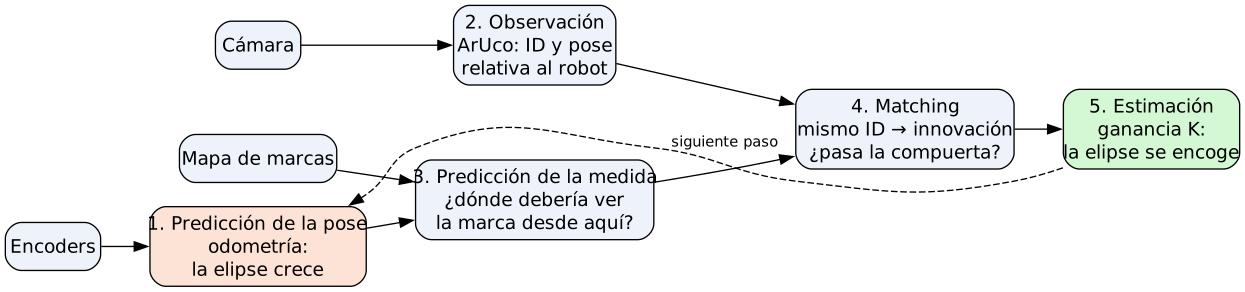
- Predecir: $\hat{x}^- = \hat{x} + \Delta s$, $\;P^- = P + Q$ · la incertidumbre crece
- $\Delta s$: avance medido con los encoders · $Q$: varianza que agrega ese avance
- Corregir con la marca y la ganancia $K$: $P$ cae · el error queda acotado
En Python
x, P = 0.0, 0.0              # estimación (m) y varianza (m²)
Q_POR_METRO = 0.0004         # varianza que agrega la odometría por metro
R = 0.01 ** 2                # la marca: σ = 1 cm

def predecir(x, P, ds):      # ds: avance medido con los encoders
    return x + ds, P + Q_POR_METRO * abs(ds)

def corregir(x, P, z):       # z: posición medida con la marca
    K = P / (P + R)
    return x + K * (z - x), (1 - K) * P
- $Q$ y $R$ se miden: $R$ con el robot quieto frente a la marca, $Q$ con las vueltas de la semana 12
En 2D: la elipse de incertidumbre
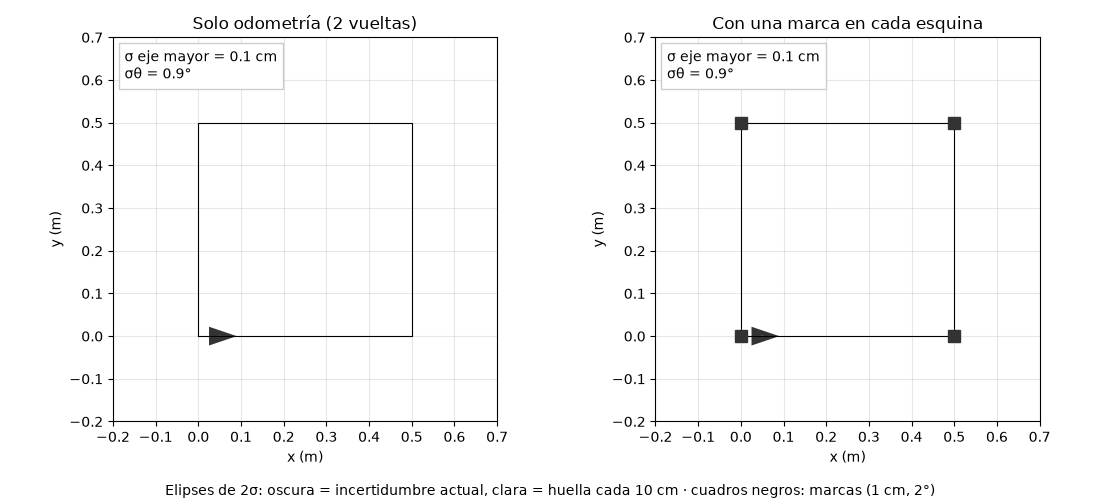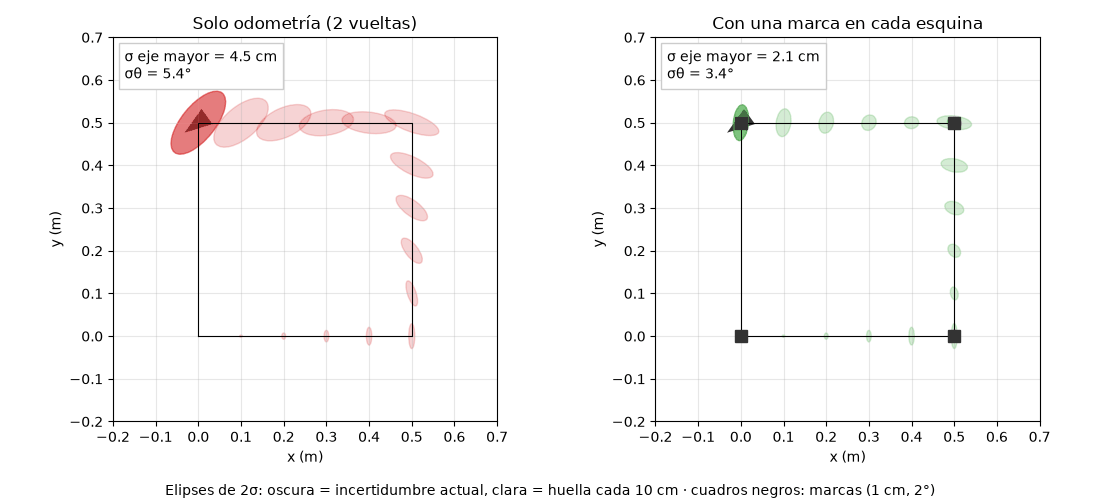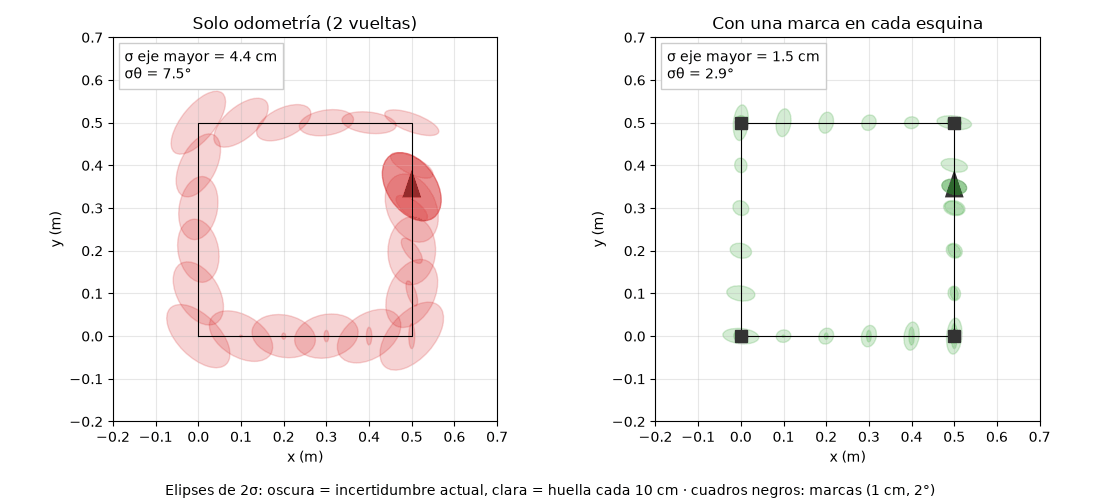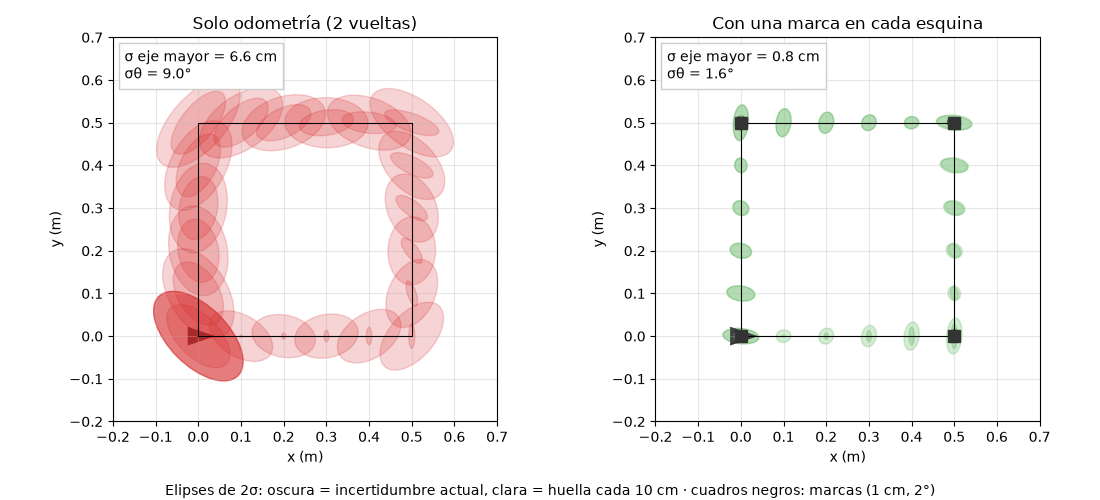
$$\Sigma^- = F_p\, \Sigma\, F_p^T + F_{rl}\, Q\, F_{rl}^T \qquad Q = \begin{bmatrix} k\,|\Delta s_r| & 0 \\ 0 & k\,|\Delta s_l| \end{bmatrix}$$
- $\Sigma,\ \Sigma^-$: covarianza de $(x, y, \theta)$ antes y después del paso · $Q$: varianza nueva de cada rueda
- $F_p$: transforma la incertidumbre que ya había · $F_{rl}$: hace entrar el error de cada rueda
- $\Delta s_r,\ \Delta s_l$: avance de la rueda derecha e izquierda · $k$: constante de error: se mide
Corregir en 2D
Si el marcador entrega la pose completa $z = (x, y, \theta)$:
$$K = \Sigma^- \left(\Sigma^- + R\right)^{-1} \qquad \hat{x} = \hat{x}^- + K\,(z - \hat{x}^-) \qquad \Sigma = (I - K)\, \Sigma^-$$
- $\hat{x}^-,\ \Sigma^-$: pose predicha y su covarianza · $R$: covarianza de la medida del marcador
- $K$: ganancia, ahora una matriz de 3 × 3 · $I$: matriz identidad · $\hat{x},\ \Sigma$: pose corregida
- Las mismas fórmulas de 1D: la división se vuelve una inversa de matriz
- La innovación del ángulo se envuelve entre −180° y 180°
- Si el sensor mide otra cosa (distancia y ángulo a la marca), se linealiza: Kalman extendido (EKF)
¿Cuándo no creerle al marcador?
$$d^2 = \frac{(z - \hat{x}^-)^2}{P^- + R} \qquad \text{si } d^2 > 9 \;(3\sigma) \;\Rightarrow\; \text{descartar la medida}$$
- $d^2$: distancia de Mahalanobis al cuadrado: la innovación medida en varianzas
- $z - \hat{x}^-$: innovación · $P^- + R$: la varianza que el filtro espera para ella
- $9 = 3^2$: una innovación de más de 3 desviaciones casi nunca es ruido
| Lo que dice el marcador | Innovación | d² | Decisión |
|---|---|---|---|
| 49.5 cm | −2.5 cm | 0.6 | se usa |
| 40 cm | −12 cm | 14.4 | se descarta |
SLAM
SLAM
| Para localizarme... | Para hacer el mapa... |
|---|---|
| necesito el mapa | necesito saber dónde estoy |
$$\mathbf{x} = \big(\underbrace{x,\; y,\; \theta}_{\text{robot}},\; \underbrace{m_{1x},\; m_{1y},\; \dots,\; m_{Nx},\; m_{Ny}}_{\text{marcas}}\big)$$
- $x, y, \theta$: pose del robot · $m_{ix}, m_{iy}$: posición de la marca $i$ · $N$: número de marcas
- Con 8 marcadores: estado de 19 números y covarianza de 19 × 19 = 361
- El robot y las marcas se estiman juntos, en el mismo filtro
Cerrar el lazo
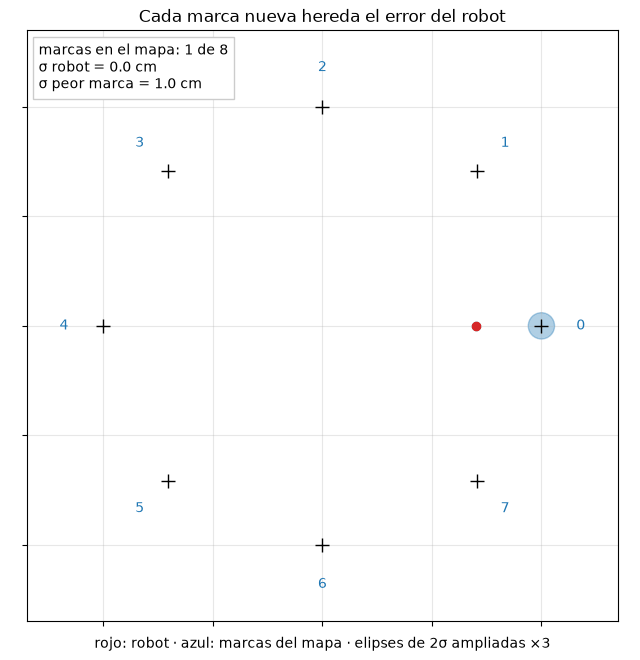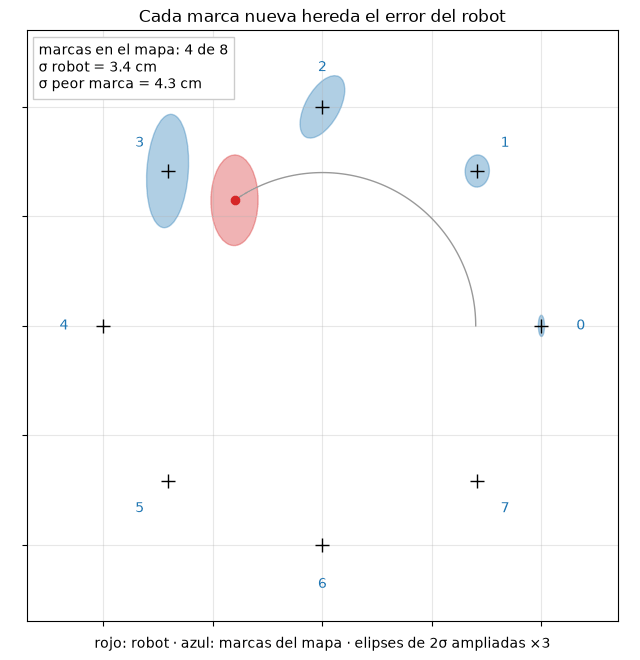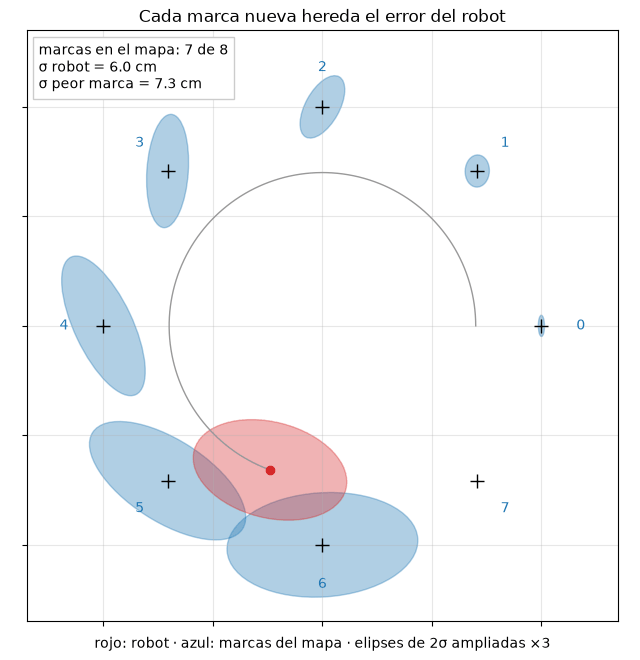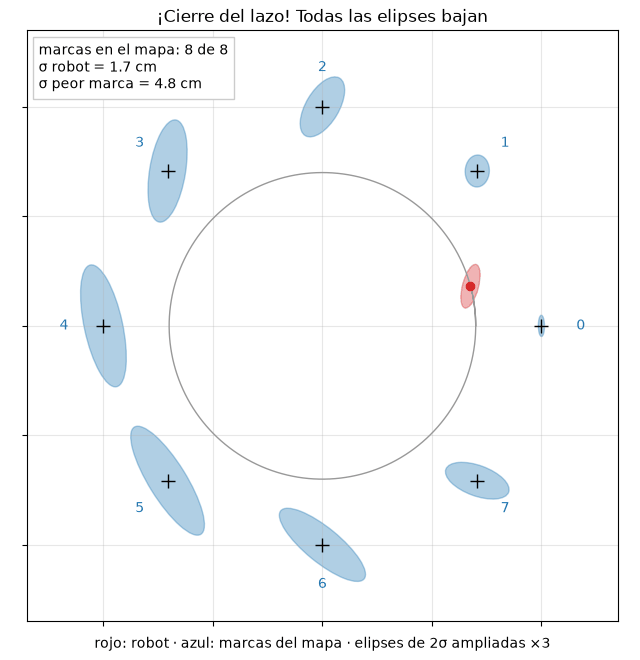
- Cada marca nueva hereda la incertidumbre del robot · al volver a la marca 0, todas bajan
SLAM hoy
| Desafío | Por qué es difícil |
|---|---|
| Reconocer que volví | dos lugares parecidos: aliasing otra vez |
| Entornos dinámicos | personas, sillas y cajas que cambian de lugar |
| Escala | miles de marcas: la covarianza crece con el cuadrado |
- Aspiradoras robot: láser o cámara · celulares (realidad aumentada): cámara + IMU
- Hoy se combinan submapas locales precisos con un grafo topológico global
Prácticas de la semana
| # | Guía | Qué se ve |
|---|---|---|
| 1 | Markov | RHINO se ubica sin saber dónde arrancó: grilla de 15 cm, partículas y secuestro |
| 2 | Kalman | EKF con la odometría y las columnas; qué pasa al apagar las marcas |
| 3 | SLAM | RHINO arma el mapa de columnas y cierra el lazo |
Simulador: RHINO en el museo (Webots), con la planta de la Fig. 4 de Burgard et al. 1998 · Guías: Semana 15 en el sitio
¿Qué nos llevamos hoy?
Un compañero programa la localización de Markov para el piso de 2 × 2 m del simulador con celdas de 1 cm y 1°, y cada paso tarda varios segundos. ¿Qué le proponen, sabiendo que el robot siempre arranca sobre el marcador 1?
Con $R$ muy pequeño, su filtro hace exactamente lo mismo que el programa de la semana 13; con $R$ muy grande, lo mismo que el de la semana 12. ¿Por qué pasa eso, y cómo escogerían $R$ con su robot?
Ponen los 8 marcadores sin medir dónde quedaron y el robot hace SLAM. Al volver al primer marcador, el programa corrige la posición de todos los marcadores, no solo la del robot. ¿Es un error del programa?